Phonon TTSを固定4入力でCPU実測:cold・warm・localの6回
cloud APIへ文章を送らずに読み上げ音声を作りたいとき、model cardの「on-device」だけでは、自分のPCで何秒かかるか、初回と2回目で何が違うかは分かりません。そこでPhonon 31m EnglishをWindows CPUで動かし、通常文・日付・電話+時刻・code+数字の固定4入力をcold/warm/local folderの6回でWAV化しました。
最終runでは、空のmodel cacheを使った通常文が7,832ms、cache後の4入力が1,142〜1,552ms、取得済みlocal folderを指定した通常文が819msでした。全6件でmono/24kHz/16-bit PCMのWAVを生成できました。
ただし、これは音質試験ではありません。WAVを聞く試験やASR転写を行っていないため、電話番号・日付・codeを正しく発音したとは結論しません。また--seed 42を固定しても、連続2 runでSHA-256が一致したのは6件中3件でした。生成成功とbyte再現性も分けて扱います。
公式説明:11月5日はmodel公開日ではない
Hugging Faceの11月5日blogは、Phononを「2週間前にopenした」と説明しています。したがって、11月5日をweightsの公開日とは扱いません。同blogでは、Phonon 31mがApache 2.0で、serverやnetworkを必要とせず端末内で動くと説明しています。
31m Englishのmodel cardで確認した対象は、audio tokenizerを除く31M parameters、q8 weights 64.5MB、English、mono 24kHz、Apache 2.0です。runtime READMEは、CLIの初回実行でdefault modelをdownloadしてcacheすること、Hub repoをcommitへpinするかlocal folderを指定できることを案内しています。
これらは提供元の仕様説明です。本稿の独自証拠は、次のWindows CPUで実行した6回の結果です。公式benchmarkや「高品質」という表現を自分の実測へ置き換えません。
検証条件:認証なし、追加費用0円
2026年11月6日、次の条件で実行しました。
| 項目 | 条件 |
|---|---|
| OS/device | Windows x64、CPU。ptts --build-infoはCPU、AVX有効、6 threads |
| CLI | ptts 0.6.0を既存uvxから実行 |
| model | gradium/phonon-31m-en@92741c5b07d085ff840e26fea8ce43110b87852f |
| model card | license apache-2.0を実行時に照合 |
| 推論条件 | --lang en --rewrites all --quant q8_0 --seed 42 --threads 6、checkpoint既定voice |
| cache | runごとに一時HF_HOMEへ隔離。implicit tokenを無効化 |
| 認証・費用 | account、token、API key、課金APIなし。追加費用0円 |
一時cacheのsnapshotは4 files、合計65,051,089 bytesでした。最大のmodel.q8.ggufは64,512,352 bytesで、ほかにtokenizer、default voice、configが入りました。これは今回CLIが取得した合計で、model cardの「64.5MB」はweights file単体です。
packageを一時環境へ準備する時間はcoldの7,832msへ含めません。6件の時間はCLI起動、model load、推論、WAV保存を含むwall clockで、純粋な推論latencyではありません。
固定4入力・6回の結果
入力は次の4種類です。plainだけはcold、warm、local folderの3条件で繰り返しました。
| case | 入力の種類 | run条件 | wall time | WAV長 | bytes |
|---|---|---|---|---|---|
| cold_plain | 通常文 | online・空model cache | 7,832ms | 2.96秒 | 142,124 |
| warm_plain | 同じ通常文 | online・warm cache | 1,142ms | 2.96秒 | 142,124 |
| warm_date | 日付 | online・warm cache | 1,297ms | 3.84秒 | 184,364 |
| warm_phone | 電話+時刻 | online・warm cache | 1,552ms | 6.48秒 | 311,084 |
| warm_code | code+数字 | online・warm cache | 1,310ms | 4.08秒 | 195,884 |
| local_offline_plain | 同じ通常文 | local folder+offline flag | 819ms | 2.96秒 | 142,124 |
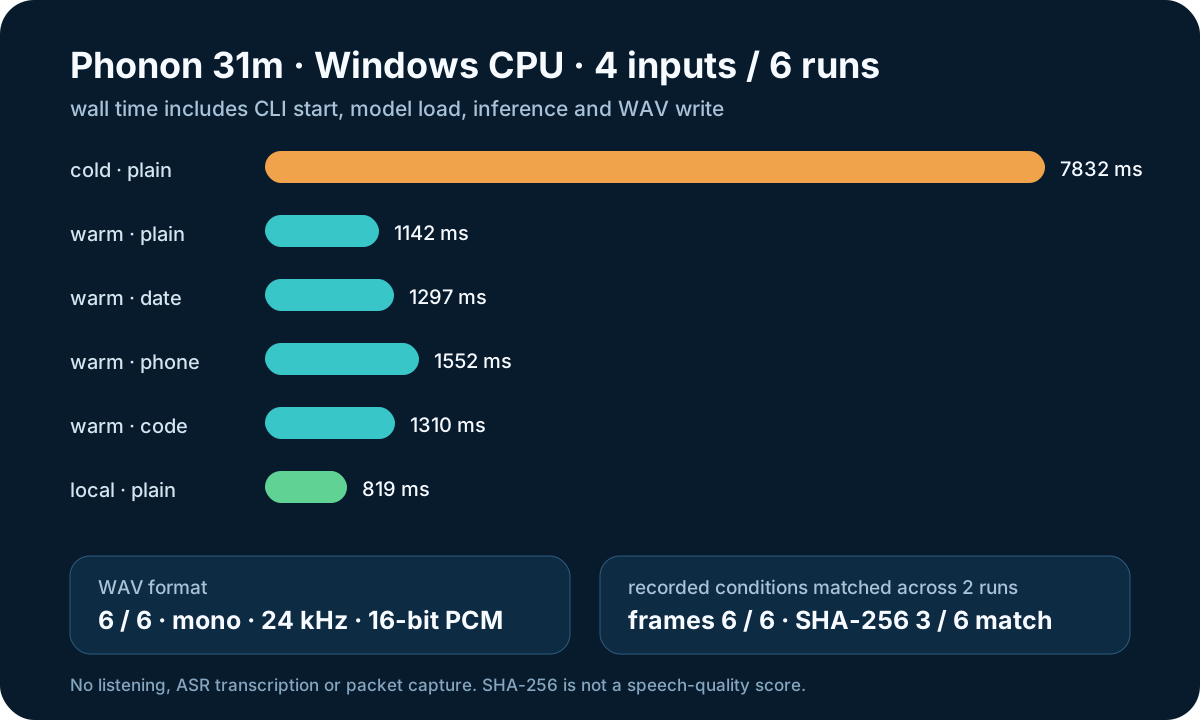
coldの通常文はwarmの同文より約6.9倍、local folderより約9.6倍のwall timeでした。ただしcoldにはmodel downloadが入ります。network、CPU、disk cacheが変わる別のPCへこの倍率を一般化しません。
local_offline_plainは、coldで取得したsnapshot folderを--modelへ渡し、HF_HUB_OFFLINE=1を設定してexit 0となりました。packet captureは行っていないため、「通信が一切なかった」という独自測定ではありません。確認できたのはlocal folder入力とoffline flagを組み合わせたCLIが、今回の環境でWAVを生成したことです。
seedを固定してもSHA-256は6件中3件だけ一致
同じscriptを連続2回実行し、比較前にptts版、model revision、seed、threads、device、build、quant、rewrites、voice、入力ID/本文、run種別、WAV形式条件をJSONで照合しました。欠落・差異があれば比較を生成せず停止します。今回の記録はこれらの条件が一致してからcaseごとのWAVを比較したものです。machine identityとbackground loadは独立記録していないため、「同じmachine条件を証明した」とは扱いません。
| 比較項目 | 一致 |
|---|---|
| frame数 | 6 / 6 |
| WAV SHA-256 | 3 / 6 |
warm plain、warm code、local folderの3件はhashが一致し、cold plain、warm date、warm phoneは一致しませんでした。最終run内でも、同じ通常文の3条件はすべて71,040 frames/142,124 bytesでしたが、hashは2種類ありました。
この結果から言えるのは、今回のptts 0.6.0/Windows CPU/process分離条件では、--seed 42を付けただけでWAVのbyte同一性を保証できなかったことです。hash不一致の原因と音響上の差は未確認です。frame数やbytesが同じでも同じ発音・品質とは限らず、hashが違っても発話内容が違うとは限りません。
PowerShellで再現し、標準PythonでWAVを検査する
script、固定入力、記録結果、11 testsをまとめたZIPを新しいfolderへ展開します。記録済み結果だけならnetworkなしで検査できます。
python .\validate_results.py .\results\experiment.json
python -m unittest discover -s tests -p 'test_*.py' -v
実験をやり直す場合は、約65MBのmodel関連fileと一時packageを取得します。
pwsh -NoProfile -ExecutionPolicy Bypass -File .\run_experiment.ps1scriptは空の一時HF_HOMEを作り、recorded revisionとmodel card licenseを照合してから6回生成します。標準Pythonのwaveでchannels、sample rate、sample width、frames、duration、bytes、SHA-256をJSON/CSVへ保存します。local絶対path、ユーザー名、token型文字列は公開resultへ残しません。
11 testsは、正常なmono 24kHz WAV、stereo拒否、16kHz拒否、生成失敗、記録済み6 case、絶対path、case欠落、不正hashに加え、比較条件一致、thread差の拒否、入力差の拒否を検査します。機械検査は音質、発音、license適合、network不使用を保証しません。
実務への影響:生成、品質、再現性を3段階に分ける
読み上げを制作工程へ入れる前に、次を別々に合格させます。
- 生成可能性:対象PCでexit 0、必要なWAV format、cold/warm時間、cache容量を記録する。
- 内容品質:実際に聞き、日付・電話・略語・codeを期待どおり読むか、人手または適切な評価setで確認する。
- 再現性:model revision、runtime version、voice、seed、rewrite、device条件を残し、byte一致が必要なら複数runでhashを確認する。
今回合格したのは1の有限条件です。2は未実施、3はframe数一致の一方でhash不一致を検出しました。英語だけの31mを日本語記事の読み上げへ直結させず、まず英語fixtureで採用条件を固定します。
model取得のrevisionとcacheを別途点検したい場合は、hf CLIの4状態検証が関連します。公開物の内部導線はWindowsの内部リンク検査で確認できます。
表紙は概念画像で、実際の音声品質や検証結果の証拠には数えていません。